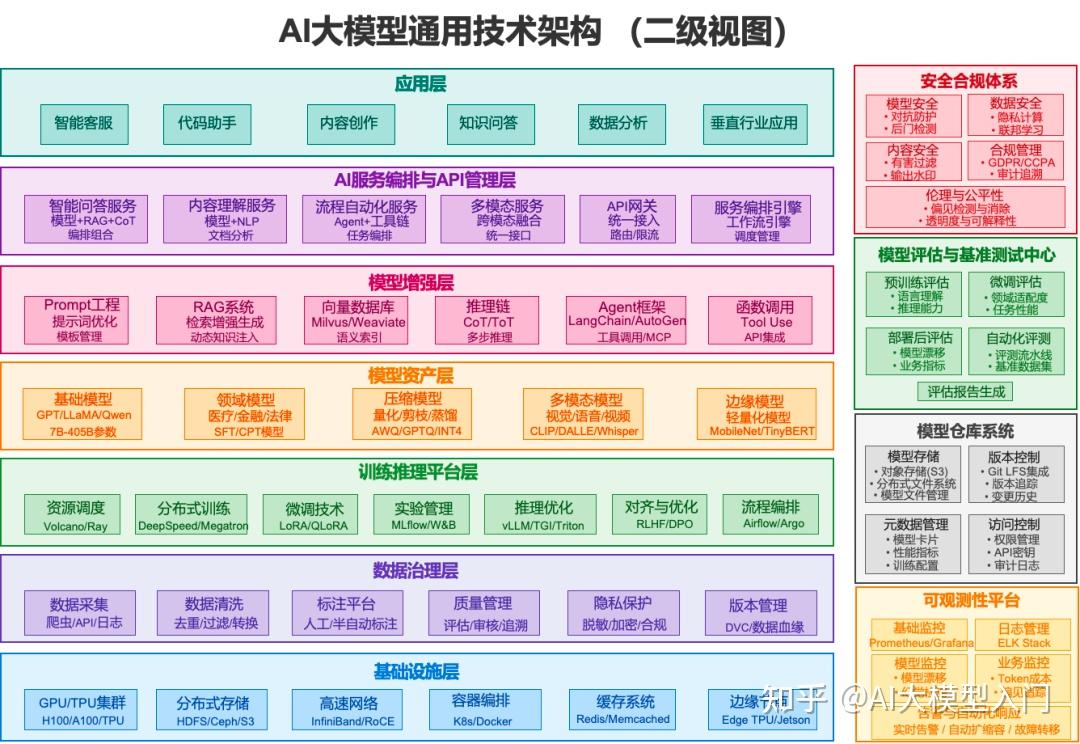
目录采用“AI 大模型通用技术架构”分层;每篇笔记聚焦一个技术模块的原理、公式、演进和边界。
#技术总线
基础设施 → 数据治理 → 预训练 → 模型资产 → 后训练与推理 → 模型增强 → 服务编排 → 应用;评测、安全、模型版本贯穿各层。
#阅读原则
- 预训练回答基础能力从哪里来;后训练回答行为与推理偏好如何改变;两者不能合并。
- 模型资产解释参数化结构;模型增强解释不改权重时如何增加证据、搜索和行动。
- 公式只放在其唯一负责模块;其他页面只链接,不重复推导。
- 横切体系解释评测、可靠性、安全、版本与观测如何影响各层技术结论。
#模块索引
阅读总线:先按下图定位层级,再点击对应模块。各篇技术路线均用单行箭头表示;算法细节、公式与边界留在各自模块。
#01_基础设施层
- 异构计算:CPU、GPU、TPU与NPU
- 存储层次:寄存器、SRAM、HBM与DRAM
- 算子、带宽与 Roofline 模型
- 节点内互联:PCIe、NVLink、NUMA 与 NVSwitch
- 跨节点网络与集合通信:IB、RoCE 与 AllReduce
- 分布式存储、数据读取与 Checkpoint
- 容器、隔离与资源调度原理
- 边缘设备与端侧推理约束
#02_数据治理层
- 数据来源、许可与经验分布
- 文本解析、规范化与基础清洗
- 去重:精确去重、MinHash 与语义去重
- 质量过滤、数据配比与课程学习
- 标注、偏好数据与人类反馈
- 隐私、脱敏与数据安全
- 数据版本、血缘与污染控制
- Tokenizer、样本格式与 Packing
#03_训练推理平台层
#04_模型资产层
#05_模型增强层
#06_服务编排与API管理层
#07_应用层
#08_横切体系
#维护规则
- 新技术先判断所属层,再新建页面;不要以框架名或项目名建重复笔记。
- 新算法必须写清:目标函数、训练信号、解决的前一问题、带来的新问题。
- 算法缩写不是分类;例如 RLAIF 是反馈来源,RLVR 是奖励来源,GRPO/DAPO/GSPO/GFPO 是在线优化机制。