所属: 基础设施层。 本页边界: 解释多台服务器之间为什么需要通信、数据经过哪些硬件、网络怎样组织,以及 AllReduce、All-to-All 等集合通信如何利用物理网络。
#0. 阅读主线:先分清七个问题
大模型训练中的网络问题可以沿着一条因果链理解:
训练并行方式 → 通信需求 → 集合通信原语 → 集合通信算法 → 传输网络 → 物理拓扑与路由 → 系统级优化
| 层次 | 典型技术 | 回答的问题 |
|---|---|---|
| 训练并行方式 | DP、TP、PP、EP、ZeRO/FSDP | 为什么需要通信、需要传什么 |
| 集合通信原语 | AllReduce、AllGather、ReduceScatter、All-to-All | 通信结束后,每个 rank 应得到什么 |
| 集合通信算法 | Ring、Tree、Double Binary Tree、分层 AllReduce | 多个 rank 按什么顺序交换数据 |
| 数据传输机制 | RDMA、GPUDirect RDMA | 数据怎样减少 CPU 参与和中间拷贝 |
| 网络体系 | InfiniBand、RoCEv2 | 数据通过哪一种网络协议栈传输 |
| 物理拓扑与路由 | Clos/Fat-Tree、Rail-Optimized、Dragonfly、ECMP、UGAL | 服务器和交换机怎样连接,数据包走哪条路径 |
| 系统级优化 | 通信重叠、SHARP、对称内存、RailS | 如何进一步降低通信时间和尾延迟 |
一条典型的跨节点 GPU 通信路径是:
源 GPU → NVLink/PCIe → 源 NIC → Leaf 交换机 → Spine/Core → 目标 Leaf → 目标 NIC → PCIe/NVLink → 目标 GPU
其中:
- rank:参加分布式通信的进程编号;GPU 训练中通常一个 rank 对应一张 GPU。
- NIC/HCA:服务器接入网络的网卡;HCA 是 InfiniBand 中常用的主机通道适配器。
- Leaf:直接连接服务器的叶交换机,也常承担 ToR(Top-of-Rack,机架顶)角色。
- Spine:连接多个 Leaf,为不同机架提供多条等价路径。
- Core:当规模超过两层 Clos 的容量时,用于继续扩展网络。
最重要的区分: Fat-Tree、Rail 和 Dragonfly 描述物理网络怎样连接;Ring 和 Tree 描述集合通信逻辑上怎样传数据。Ring AllReduce 完全可以运行在 Fat-Tree 物理网络之上。
#第一部分:从一次通信建立物理图景
#1. 为什么大模型训练需要跨节点通信
#1.1 从两台服务器同步梯度开始
设两台服务器各有 8 张 GPU,共 16 张 GPU。数据并行训练时,每张 GPU:
- 保存一份相同的模型参数;
- 读取不同的 mini-batch;
- 独立完成前向传播和反向传播;
- 得到自己的局部梯度;
- 与其他 GPU 合并梯度,再执行相同的参数更新。
设第 个设备得到局部梯度 ,设备数为 ,全局平均梯度为
只在单台服务器内训练时,梯度可以主要通过 NVLink、NVSwitch 或 PCIe 交换。模型或并行规模超过单机容量后,数据必须经过 NIC 和交换网络到达其他服务器。
#1.2 Scale-up 与 Scale-out
| 范围 | 中文解释 | 常见互联 | 主要特点 |
|---|---|---|---|
| Scale-up | 向上扩展:扩大单节点或单个高速互联域 | NVLink、NVSwitch、PCIe | 带宽高、延迟低、覆盖设备数有限 |
| Scale-out | 向外扩展:连接更多服务器或机架 | InfiniBand、RoCE/Ethernet | 覆盖规模大,但带宽更低、路径更长、拥塞更复杂 |
NVL72 等 NVLink 域可以把一部分 TP(张量并行)或 EP(专家并行)通信留在 Scale-up 域内;模型或专家跨出该域后,仍然需要 Scale-out 网络。
#2. 先理解网络性能的四个量
#2.1 延迟与带宽
一次点到点传输可以先用最简单的近似式理解:
其中:
| 符号 | 含义 | 单位 |
|---|---|---|
| 一次通信的完成时间 | s | |
| 软件启动、同步、协议处理和链路传播构成的固定延迟 | s | |
| 消息大小 | Byte | |
| 考虑协议开销、竞争和路径后的有效带宽 | Byte/s |
- 小消息中, 占比大,减少启动次数和同步次数更重要。
- 大消息中, 占比大,提高链路利用率和减少拥塞更重要。
- 标称带宽不等于有效带宽;协议开销、PCIe 路径、多个作业竞争和路由不均都会降低 。
#2.2 跳数、拥塞与尾延迟
- 跳数(hop count):数据包经过的交换机链路阶段数。跳数越多,通常延迟和发生拥塞的机会越大。
- 拥塞(congestion):多个流同时竞争同一输出端口或链路,导致排队。
- 尾延迟(tail latency):P95、P99 等慢请求的完成时间。同步训练由最慢 rank 决定,因此尾延迟比平均延迟更关键。
- straggler(拖尾设备):因计算、存储、路由或链路异常而明显慢于其他设备的 rank。
同步迭代时间可以粗略写成
其中 和 分别是第 个设备的计算时间与未被隐藏的通信时间。
#第二部分:训练到底需要传什么
#3. 集合通信原语
#3.1 什么是归约
归约(Reduction) 是对多个参与方上的同形状数据应用结合性操作,例如求和、最大值或最小值,得到合并结果。
AllReduce 是归约 + 把结果交给所有 rank。它不是“把数据传到主节点”即可。NCCL 对 AllReduce 的语义是:每个 rank 提供输入数组,归约结果写入每个 rank 的接收缓冲区。
#3.2 四种核心原语
| 原语 | 中文名 | 每设备输入 → 输出 | 数学作用 | 典型用途 |
|---|---|---|---|---|
| AllReduce | 全归约 | 同形状张量 → 归约后的完整张量 | 对各 rank 数据逐元素归约,所有 rank 得到相同结果 | 数据并行梯度同步;TP 部分和归约 |
| ReduceScatter | 归约散射 | 同形状张量 → 归约结果的一个分片 | 先归约,再把结果切成 份,每个 rank 保留一份 | FSDP/ZeRO 梯度与优化器分片 |
| AllGather | 全收集 | 一个分片 → 所有分片拼成的完整张量 | 收集各 rank 的分片,所有 rank 得到完整拼接 | 使用前恢复参数或激活 |
| All-to-All | 全交换 | 发往不同目标的分片 → 来自不同来源的分片 | 每个 rank 向其他 rank 发送不同数据 | MoE 专家 token 派发与返回 |
在采用相同归约与分片规则时:
ReduceScatter → AllGather
在逻辑结果上等价于一次 AllReduce。
易混点:
- AllGather 只拼接,不执行求和。
- AllReduce 给每个 rank 相同结果,不保留每个发送者的独立片段。
- All-to-All 中每个目标收到的内容不同,发送量还可能随 MoE 路由分布变化。
#3.3 并行策略怎样改变通信
| 训练方式 | 主要通信 | 解决了什么 | 新问题 |
|---|---|---|---|
| 单卡 | 无跨卡同步 | 执行路径简单 | 显存与算力受限 |
| 数据并行 DP | 梯度 AllReduce | 扩大训练吞吐 | 梯度同步等待 |
| ZeRO/FSDP | ReduceScatter + AllGather | 减少状态复制 | 参数访问时机和带宽压力 |
| 张量并行 TP | 层内 AllReduce/AllGather/ReduceScatter | 将单层计算拆到多卡 | 通信频率高、延迟敏感 |
| 流水线并行 PP | 相邻 stage 点到点传递激活 | 将不同层拆到多卡 | pipeline bubble 与相邻通信 |
| 专家并行 EP | token All-to-All | 稀疏扩大模型容量 | 专家热点、流量不均和尾延迟 |
每种并行方式的参数和激活切分见训练并行。
#第三部分:网络结构为什么不断演进
#4. 从两两直连到多级交换网络
#4.1 为什么不能让所有服务器两两直连
若 台服务器两两直接连接,需要的链路数为
链路数量按 增长,而且每台服务器需要大量端口。因此集群必须通过交换机复用链路。
#4.2 单交换机为什么仍然不够
最简单的交换网络是:
服务器/NIC → 一台交换机 → 目标服务器/NIC
它只有一层,路径短,但受以下因素限制:
- 交换机端口数有限;
- 单台交换机的交换容量有限;
- 所有服务器共享同一个故障域;
- 无法直接扩展到数千或数万节点。
#4.3 普通树形网络的根部瓶颈
增加交换机后,可以形成:
服务器 → 接入交换机 → 汇聚交换机 → 核心交换机
普通树形网络往往逐层收敛:下层服务器端口的总带宽大于上层链路总带宽。大量跨机架流量同时向上汇聚时,根部成为结构性瓶颈。
#5. 判断拓扑能力:超售与对分带宽
#5.1 超售比
设某个 Leaf 面向服务器的总下行带宽为 ,连接上层网络的总上行带宽为 ,则
- 当满足下式时,下行与上行按 配置,叶层没有超售。
- 当满足下式且服务器同时向 Leaf 外发送时,上行可能成为瓶颈。
例如,Leaf 下接 8 条 400 Gb/s 服务器链路,上行只有 4 条 400 Gb/s 链路:
这是一套 超售网络。
#5.2 对分带宽
对分带宽(bisection bandwidth) :把全部端点近似分成两半时,跨越两半之间最小割的总链路容量。
- 它衡量大规模全局通信能够获得多少横跨网络的容量。
- All-to-All、跨机架 AllReduce 对对分带宽尤其敏感。
- 叶层配置只是非阻塞的必要条件之一;上层端口、可用路径、故障状态和路由也必须足够。
#6. Clos / Fat-Tree:用多级带宽换通用性
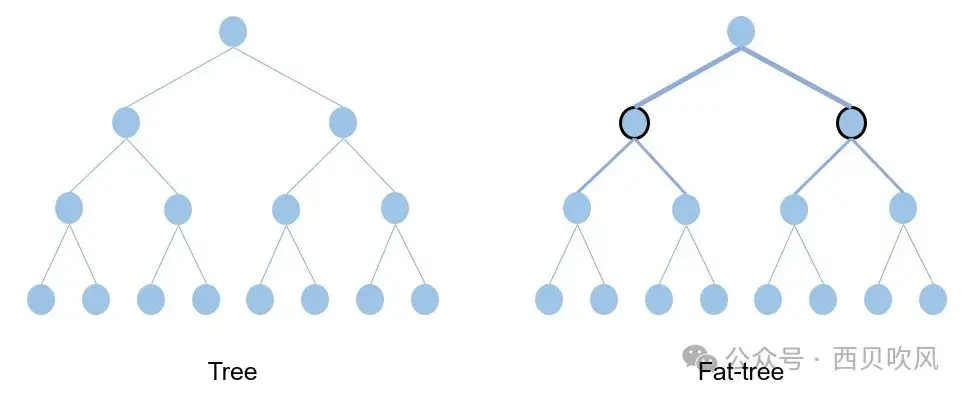
传统树形网络越接近根部越容易发生带宽收敛。Fat-Tree 的直观目标恰好相反:随着更多下层流量向上汇聚,上层也配置足够多的链路和交换容量,使“树干”随规模变粗。
Clos 是多级交换网络的一般结构;Fat-Tree 是按层配置上行容量、保持路径对称性的常见 Clos 实现。工程中通常按照以下结构组织:
服务器/NIC → Leaf → Spine → 可选 Core → Spine → Leaf → 目标服务器/NIC
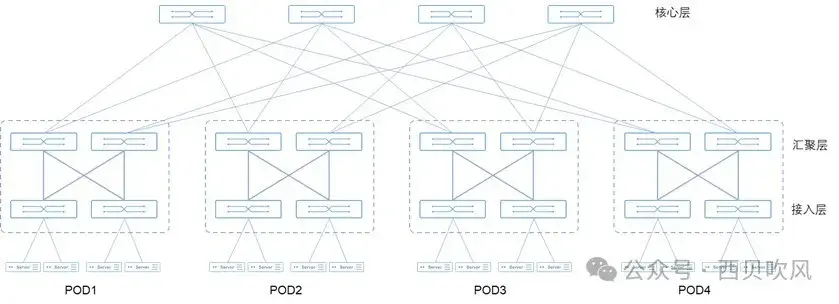
#6.1 三类交换机分别做什么
- Leaf:连接服务器或 NIC,是数据进入网络的第一层。
- Spine:连接多个 Leaf,为跨 Leaf 流量提供多条等价路径。
- Core:当交换芯片端口数不足以支撑两层网络的目标规模时,再增加一层扩展。
#6.2 Fat-Tree 解决了什么
- 在无故障、无超售且上层容量充分时,full-fat-tree 可以提供接近全对分带宽的非阻塞网络。
- 多条等价路径可以通过 ECMP 或自适应路由分散流量。
- 物理路径较规则,流量模式变化时,性能通常比稀疏全局拓扑更可预测。
- 它可以支持从非阻塞到不同超售比的多种部署方案,因此适用于 AllReduce、All-to-All 和多租户混合流量。
限定: “使用 Fat-Tree”不等于“天然非阻塞”。如果上层端口不足、使用超售、链路故障或流量集中到少数路径,Fat-Tree 仍然会拥塞。
#6.3 Fat-Tree 的成本和扩展约束
- 交换机、光模块和线缆数量大;规模越大,功耗、布线和运维压力越高。
- 受交换芯片 radix(端口数)限制,规模跨过某个边界时需要增加交换级数,成本呈阶梯式上升。
- 网络层数增加后,部分跨域路径跳数增加,低延迟业务可能受到影响。
- 如果训练流量高度局部,预留的全对分带宽可能长期没有被充分利用。
某些特定三层 Fat-Tree 配置会给出约 台交换机的估算,其中 是服务器数量, 是交换机端口数。但该表达式依赖端口上下行如何拆分、服务器有多少 NIC、网络级数和是否要求全对分带宽,不能作为所有 Fat-Tree 的通用公式。
“Fat-Tree 不适合 One-to-All 或 All-to-All”也是容易产生误解的说法。Full Fat-Tree 正是为了提高通用流量的对分带宽;真正会破坏 All-to-All 性能的是超售、路径哈希碰撞、上层故障或多租户竞争。
扩展规模也不只由一台核心交换机的端口数决定。Clos 可以增加交换机和网络级数继续扩展,但会付出更多设备、长距离链路、功耗和运维复杂度。
#6.4 SuperPOD 示例
NVIDIA DGX SuperPOD 的计算网络被描述为 rail-optimized、non-blocking、twin-plane full-fat-tree。不同产品代际和 Scale Unit 数量可采用不同级数,因此不能把所有 SuperPOD 固定描述为同一种“三层”结构。
#7. Rail-Optimized:在 Clos 上优化 NIC 映射
Rail-Optimized 不是 Fat-Tree 的替代物,而是 Clos/Fat-Tree 中服务器 NIC 到 Leaf 的接入规则。
#7.1 为什么需要 Rail
一台 8 GPU 服务器通常包含多个 NIC。若不同服务器上的 NIC 随机接入 Leaf,即使参与通信的是“相同本地位置”的 GPU,流量也可能频繁经过 Spine。
Rail 的做法是:
- 节点 A、B、C 的 NIC 0 接入同一个 Leaf 或连续 Leaf 组,形成 rail 0;
- 节点 A、B、C 的 NIC 1 接入另一个 Leaf 或 Leaf 组,形成 rail 1;
- 其余本地位置依此类推。
当 rank、GPU 与 NIC 映射正确时:
同一 rail 内的通信 → Leaf 内完成或减少上层跳数
跨 Scale Unit 或跨 rail 的通信 → 仍需经过 Spine
#7.2 它适合什么流量
- 分层数据并行 AllReduce 的节点间阶段,常由不同节点上相同本地序号的 GPU/NIC 交换对应分片。
- rail 对齐可以减少 Spine 占用、跳数和排队尾延迟。
- NVIDIA B300 SuperPOD 文档中,每组 72 个节点按 rail 对齐;同一 Scale Unit 内的每条 rail 流量距离其他节点为一跳,跨 Scale Unit 或跨 rail 流量才经过 Spine。
#7.3 它的边界
- 收益不是固定的“吞吐提升 28%”。提升幅度依赖作业规模、Leaf 覆盖范围、NCCL/PXN 路径、并行分组和背景拥塞。
- Rail 依赖拓扑感知的任务放置。rank、GPU 或 NIC 映射错误时,原本的 rail-local 流量会变成跨 rail 流量。
- MoE All-to-All 更接近全局交换,容易跨 rail 并在 Spine 或少数目标专家处形成热点。
- 因此 Rail 需要与专家放置、自适应路由及后文的 RailS 调度共同设计。
#8. Dragonfly / Dragonfly+:用稀疏全局链路换低直径
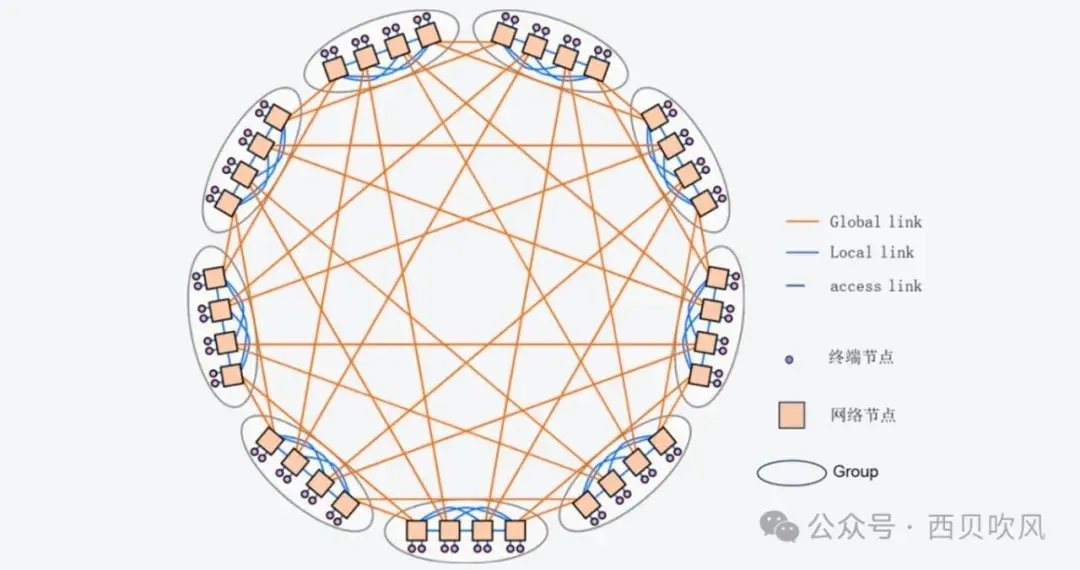
Fat-Tree 的通用性来自大量交换机和全局链路。Dragonfly 的出发点是:把节点组织成多个高带宽组,组内连接较密,只用一部分全局链路连接不同组,从而降低超大规模系统的全局布线成本。
Dragonfly+ 常把每个 island 构造成两级 Leaf/Spine 子网,再用全局链路连接不同 island。
#8.1 优势与代价
- 优势:网络直径低,跨大规模系统通常只需少量阶段;长距离全局链路数量可能少于同规模 full-fat-tree。
- 适合:局部性强、任务放置可控、规模达到数万节点的 HPC 流量。
- 代价:组间带宽通常比组内更稀缺,全局链路可能形成结构性瓶颈。
- AI 边界:MoE All-to-All、跨组参数同步和多租户突发流量容易同时竞争少数全局链路,放大尾延迟。
#8.2 参数化理解
在经典 Dragonfly 记号中:
- :每个组包含的路由器数量;
- :每个路由器连接的全局链路数量;
- :组的数量。
在一种最大化组间直接连接的经典配置中,有
该关系依赖特定 Dragonfly 构造,不应直接推广到所有 Dragonfly+ 部署。
#8.3 三类路由算法
-
Minimal Routing(最短路由) 直接走向目标组。典型路径最多包含 1 条 Global Link 和 2 条 Local Link,即最多 3 个路由阶段。路径短,但热点全局链路拥塞时缺乏绕行能力。
-
Valiant / VLB(非最短负载均衡路由) 先选择一个中间组,再从中间组前往目标组。典型最坏路径可包含 2 条 Global Link 和 3 条 Local Link,即最多 5 个路由阶段。它用额外跳数换取更均匀的流量。
-
Adaptive Routing(自适应路由) 根据拥塞状态在最短路径和绕行路径之间选择。UGAL(Universal Globally-Adaptive Load-balanced routing,全局自适应负载均衡路由)及 UGAL-L、UGAL-G 等变体,会用不同范围的拥塞信息作决策。
NVIDIA InfiniBand 的 DF_PLUS 自适应路由可根据候选端口负载选择路径,但配置、状态采集、验证和故障定位也更加复杂。
#9. 拓扑、路由和流量模式必须一起看
| 设计 | 主要机制 | 适合的流量 | 主要失效模式 | 成本与灵活性 |
|---|---|---|---|---|
| Full Fat-Tree / Clos | 多级等价路径与高对分带宽 | 通用 AllReduce、All-to-All、多租户混合负载 | 超售、哈希碰撞、上层故障 | 成本最高,流量适应性最好 |
| Rail-Optimized Clos | 在 Clos 上把相同位置 NIC 对齐到同一 Leaf/Leaf 组 | rail-local AllReduce、稳定并行分组 | 放置错误、跨 rail、MoE 热点 | 增加布线与调度约束 |
| Dragonfly / Dragonfly+ | 高带宽组内网络 + 稀疏全局链路 | 局部性强、规模很大的 HPC 流量 | 全局链路拥塞、复杂路由和高尾延迟 | 长距离链路较少,流量适应性较弱 |
选择逻辑可以概括为:
通用大型 AI 集群先保证 Clos/Fat-Tree 的对分带宽 → 对稳定的 DP/TP 分组叠加 Rail-Optimized → MoE 保留足够跨 rail 带宽并联合专家放置与拥塞控制 → 局部性强且能显式控制任务映射的超大 HPC 系统再考虑 Dragonfly/Dragonfly+
#第四部分:数据通过什么网络传输
#10. RDMA、InfiniBand 与 RoCE
#10.1 RDMA 解决什么问题
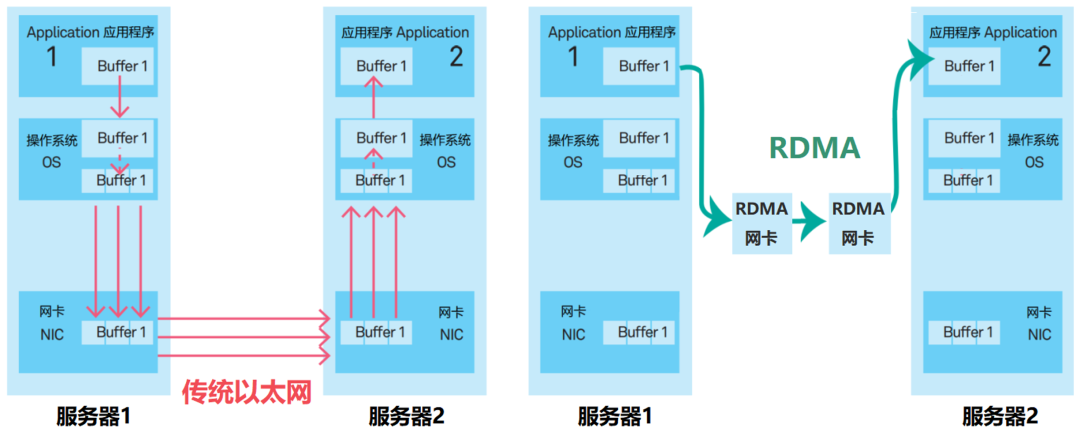
RDMA(Remote Direct Memory Access,远程直接内存访问)允许网卡直接访问远端已注册内存,减少远端 CPU 参与、内核协议栈处理和中间拷贝。
RDMA 是一种数据传输机制,不是某一种线缆,也不是某一种物理拓扑。
#10.2 GPUDirect RDMA
普通路径可能需要:
GPU 显存 → 主机内存 → NIC → 网络
GPUDirect RDMA 允许 NIC 在受支持的平台上直接访问 GPU 显存,减少主机内存中转:
GPU 显存 → NIC → 网络
但实际性能仍取决于 GPU、NIC 的 PCIe/NVLink 拓扑、IOMMU、NUMA 位置和驱动配置。GPUDirect RDMA 文档
#10.3 InfiniBand
InfiniBand(IB)是面向高性能计算和数据中心的网络体系,原生支持 RDMA 语义。
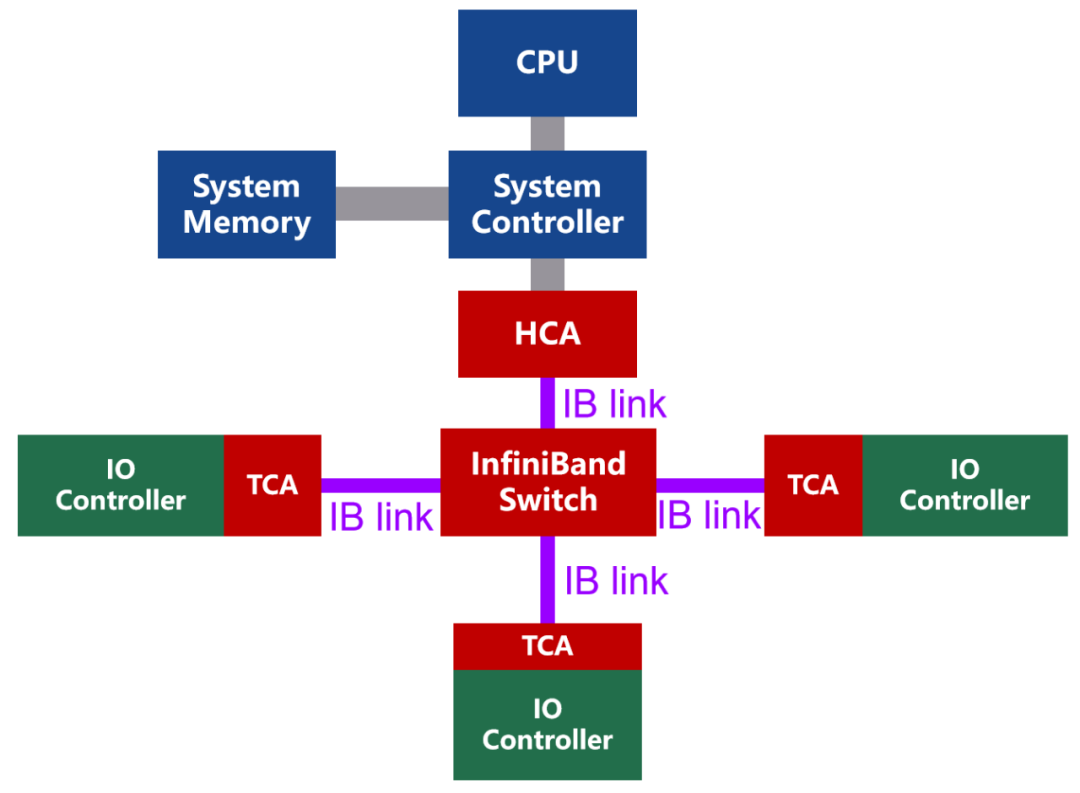
InfiniBand 结构中的常见组件包括:
- HCA(Host Channel Adapter,主机通道适配器):服务器端的 IB 网卡。
- TCA(Target Channel Adapter,目标通道适配器):面向目标设备或服务的通道适配器概念。
- InfiniBand link:电缆、光纤或板上链路。
- 交换机与路由器:负责组网和转发。
IB 使用基于信用的链路级流控(Credit-Based Flow Control):下游根据接收缓冲区能力向上游提供信用,发送端只有在拥有足够信用时才发送,从而避免因接收缓冲区溢出造成的丢包。它不能消除物理链路错误,也不能自动消除多流竞争造成的拥塞。
更细地看,下游交换机可以按 Virtual Lane(虚拟通道)维护接收缓冲区状态,并向上游通告可发送额度。部分 IB 资料用 FCCL 描述流量控制信用限制,并结合 ABR(已接收块计数)与可用缓冲空间判断发送窗口。不同代际设备的字段和实现细节可能不同,但原则相同:发送方必须先确认下游有接收空间。
IB 交换机还可使用自适应路由:交换机根据候选端口的队列深度、端口拥塞等级或其他负载信号选择路径,避免所有流量集中在同一条最短路径。具体产品可能按包、按流或按有序性约束作选择,不能把所有 IB 设备概括成固定的“逐包独立选路”。
#10.4 RoCEv2
RoCE(RDMA over Converged Ethernet)在以太网上承载 RDMA。RoCEv2 使用 UDP/IP 封装,可以跨三层 IP 网络路由。
RoCE 网络常联合使用以下机制:
- PFC(Priority Flow Control,优先级流控):当接收缓冲区超过 XOFF 阈值时,逐跳暂停指定优先级的上游流量;缓冲区下降到恢复阈值后再继续发送。
- ECN(Explicit Congestion Notification,显式拥塞通知):交换机在队列超过下限阈值时开始按概率标记,在超过上限阈值时可以标记全部报文。经典配置常把拥塞经历字段标为
11;接收端随后通过拥塞通知把信号反馈给发送端。 - DCQCN(Data Center Quantized Congestion Notification,数据中心量化拥塞通知):发送端根据拥塞反馈降低速率,再逐步恢复。
工程上通常希望 ECN 在 PFC 大量触发前开始抑制发送速率,否则频繁 Pause 容易导致吞吐下降和拥塞扩散。PFC 不是 RoCE 正确运行的唯一方式;现代 RoCE 也可以结合端到端重传和更精细的拥塞控制部署在有损网络中。
原笔记引用 DeepSeek-V3 的工程讨论,是为了说明大规模训练对 RoCE 的延迟、可扩展性和配置质量极其敏感;这不能推广成“RoCE 一定不适合大模型训练”。更准确的结论是:RoCE 可以支撑大型 AI 集群,但端到端效果高度依赖拓扑、缓冲区、ECN/PFC 参数、路由和运维能力。
#10.5 IB 与 RoCE 不决定物理拓扑
| 维度 | InfiniBand | RoCEv2 |
|---|---|---|
| 网络基础 | 专用 IB 网络体系 | 以太网 + UDP/IP |
| RDMA | 原生支持 | 在以太网上承载 |
| 流控与拥塞 | 信用流控、自适应路由等 | ECN、DCQCN,可配合 PFC |
| 部署特点 | 软硬件体系集中、性能路径一致 | 可复用以太网生态,但参数调优复杂 |
| 可采用的拓扑 | Fat-Tree、Rail、Dragonfly 等 | Clos/Fat-Tree、Rail 等以太网结构 |
因此:IB/RoCE 回答“使用什么网络传输”,Fat-Tree/Dragonfly 回答“交换机怎样连接”。
#第五部分:集合通信算法怎样利用物理网络
#11. Ring、Tree 与分层 AllReduce
#11.1 逻辑拓扑不等于物理拓扑
- 物理 Fat-Tree:真实交换机和线缆形成的连接结构。
- 逻辑 Ring:NCCL 为参与通信的 rank 排列出的发送顺序。
- 逻辑 Tree:NCCL 为归约和广播建立的父子关系。
一个逻辑 Ring 的相邻 rank 在物理网络上可能相隔多个交换机,因此 rank 映射与拓扑感知非常重要。
#11.2 Ring AllReduce
Ring AllReduce 通常分为两个阶段:
- ReduceScatter:张量分块沿环传递并归约,每个 rank 最终持有一个已归约分片。
- AllGather:这些分片继续沿环传播,使所有 rank 得到完整结果。
设:
| 符号 | 含义 | 单位/条件 |
|---|---|---|
| 参与集合通信的设备数 | 正整数 | |
| 每个设备参与归约的张量大小 | Byte | |
| 每轮通信的启动与同步延迟 | s | |
| 每条有效路径的带宽 | Byte/s | |
| Ring AllReduce 近似通信时间 | s |
理想同质环上的近似时间为
每个设备的发送量约为
当 很大时,发送量接近 ,但通信轮数为 ,所以 Ring 对大消息带宽利用较好,对大量小消息则容易被启动延迟支配。
#11.3 Tree 与 Double Binary Tree
Tree AllReduce 沿树向上归约,再向下广播:
- 通信阶段数通常为 ;
- 小消息时比 Ring 更容易降低启动延迟;
- 根部或高层节点承担更多逻辑责任,需要通过双树或多树分摊负载。
Double Binary Tree 使用两棵互补二叉树,让一棵树中的内部节点尽量成为另一棵树中的叶节点,并对数据分块流水化,减少单个根节点瓶颈。
NCCL 2.4 引入了 Double Binary Tree,用于改善大规模 rank 下 Tree 类算法的带宽扩展性。它不是“所有中等消息固定采用的唯一默认算法”;实际选择仍由版本、硬件、拓扑和代价模型决定。
下面的消息区间只能作为理解算法倾向的示例,不是跨 NCCL 版本和硬件通用的固定默认阈值:
| 示例消息大小 | 常见倾向 | 原因 |
|---|---|---|
| 小于约 32 KB | Tree/低延迟算法 | 占主导,优先减少阶段数 |
| 约 32 KB–2 MB | Tree、双树或分块流水算法 | 平衡启动延迟与带宽 |
| 大于约 2 MB | Ring 或高带宽算法 | 更重视稳定占满链路 |
某些 A100 与特定 NCCL/拓扑测试中,Ring 和 Tree 的性能拐点约在 2 MB;换成其他 GPU、网络、rank 数或 NCCL 版本后,拐点会变化。NCCL 会根据运行时拓扑、消息大小、协议和代价模型选择算法,不能把表中的数值硬编码成普遍规则。
#11.4 分层 AllReduce
单节点内带宽 通常显著高于节点间带宽 。如果直接让一个 Ring 频繁穿过节点边界,就会反复经过较慢的 Scale-out 链路。
设完整梯度大小为 ,节点数为 ,每节点 GPU 数为 。一种典型分层 AllReduce 为:
| 阶段 | 操作 | 主要网络 | 每个 GPU 的结果或通信对象 |
|---|---|---|---|
| 1 | 节点内 ReduceScatter | NVLink/NVSwitch | 得到大小约 的分片 |
| 2 | 节点间 AllReduce | IB/RoCE | 相同本地序号 GPU 对 分片归约 |
| 3 | 节点内 AllGather | NVLink/NVSwitch | 重建完整梯度 |
若节点间采用 Ring,则单 GPU 节点间发送量为
以式(1)、式(2)为例:
式(1):
式(2):
如果把单 GPU 的发送和接收字节相加,双向累计如下;如果聚合一个节点 8 张 GPU 的发送流量,则为 。所以“跨 IB 数据占 25%”必须明确统计口径。
NCCL 是否采用分层算法取决于拓扑、消息大小、传输后端和版本,不能理解成所有 NVLink + IB 环境都会固定执行上述三步。
#第六部分:如何进一步降低通信开销
#12. 计算通信重叠
若计算耗时为 ,通信耗时为 ,则理想边界为
- 左端:计算和通信完全重叠。
- 右端:计算和通信完全串行。
#12.1 框架怎样实现重叠
- PyTorch FSDP / DeepSpeed ZeRO:某层梯度计算完成后立即触发 ReduceScatter,不等全部反向传播结束;前向或反向阶段预取后续参数分片。
- Megatron-LM:在满足依赖时,把 TP 的 AllGather/ReduceScatter 与 GEMM 重叠;把流水线 P2P 通信与 1F1B 调度重叠。
- WFBP(Wait-Free BackPropagation,无等待反向传播):每层梯度一旦就绪就尽早启动通信。
#12.2 重叠为什么不能消灭所有通信时间
- 前向计算若必须等待参数 AllGather,换 CUDA stream 也无法消除数据依赖。
- 多个通信操作可能竞争同一 NIC、PCIe 或网络链路。
- 最慢 rank 决定同步完成时刻。
- 重叠会占用 GPU SM、DMA 引擎、显存带宽和通信缓冲区,并非免费。
#13. SHARP:让交换机参与归约
#13.1 为什么需要网络内归约
传统端点归约中,数据到达 GPU 或 CPU 端点后再执行求和,并继续发送。网络内归约让支持该能力的交换机在数据汇聚过程中直接完成部分归约,再把聚合结果向下分发。
NVIDIA SHARP(Scalable Hierarchical Aggregation and Reduction Protocol,可扩展分层聚合与归约协议)是代表性实现。
#13.2 基本工作方式
SHARP 在网络中建立聚合树:
GPU/NIC → 聚合树叶节点 → 交换机聚合节点执行归约 → 根部结果 → 沿树分发
聚合节点(Aggregation Node, AN)是交换机中的逻辑归约资源。它可以减少相同中间数据在端点和网络之间反复流动,并减少 GPU 用于通信归约的 SM 资源。
在 SHARP 的协议描述中,聚合节点会以可被端点访问的目标资源形式参与通信;部分资料会借用 TCA(Target Channel Adapter,目标通道适配器)的接口语义解释这一角色。这里的 AN 是逻辑聚合资源,不应简单理解为服务器里新增了一块普通 TCA 网卡。
“数据量减半”只能用于特定算法、拓扑和统计口径,不能当成所有 SHARP 操作的固定结论。更稳妥的收益表述是:
- 减少端点参与的归约计算和中间流量;
- 降低多对一汇聚造成的服务器队列压力;
- 释放一部分 GPU SM 和通信资源;
- 收益取决于消息大小、并发作业、交换机能力和集合通信类型。
#13.3 SHARP 演进与公开测试数据
| 版本 | 平台 | 关键进展 | 公开测试中的代表性结果 |
|---|---|---|---|
| SHARPv1 | EDR 100G IB | 面向小消息归约和科学计算 | MPI AllReduce 最高约 5×,MPI Barrier 最高约 9× |
| SHARPv2 | HDR 200G Quantum | 扩展到大消息和 AI 训练 | AllReduce 带宽约 2×,特定 BERT 测试约 17% |
| SHARPv3 | NDR 400G Quantum-2 | 多租户网络内计算 | 特定 Azure 测试中 AllReduce 延迟接近数量级下降 |
公开资料还报告:在特定 128 MB AllReduce 基准中,16–1536 GPU 范围内 SHARP 集群带宽比对照高约 50%–63%;在特定 NVLink 4 配置中,结果从约 370 GB/s 提升到约 480 GB/s。上述数字依赖厂商测试环境,不能直接外推到任意集群。
NCCL 2.27 进一步支持 NVLink 与 InfiniBand SHARP 协同,并把相关能力扩展到 AllGather 和 ReduceScatter。官方示例中,传统 Ring 集合通信可能使用 16 个或更多 SM,而相应 SHARP 路径可降低到 6 个或更少。
#14. 对称内存与 Direct NIC(NCCL 2.27)
#14.1 对称内存
对称内存(Symmetric Memory) 让不同 GPU 上的通信缓冲区使用相同虚拟地址和匹配偏移,NCCL 因而可以采用更低同步开销的集合通信内核。
NVIDIA 公布的 NCCL 2.27 测试包括:
- 64 B AllReduce 延迟最高降低约 9 倍;
- 4 KB 和 128 KB 等中等消息在对应测试中分别约 7.6 倍和 5.6 倍;
- NVL8 域内中小消息性能最高约 2.5 倍。
这些数字描述特定 NCCL 版本、GPU 域和测试条件,不是所有集群的固定提升。
#14.2 Direct NIC
在部分 Grace Blackwell 平台上,CX8 NIC 暴露不同 PCIe 功能,其中数据直连功能可以通过 PCIe Gen6 x16 更直接地连接 GPU,减少受 Grace CPU PCIe Gen5 路径限制的影响,并支持最高 800 Gb/s 的目标网络带宽。
公开架构图将其表示为两棵虚拟 PCIe 树:一棵树中的数据直连 PF 连接 GPU PF,用于高带宽 GPU 通信;另一棵树中的常规 NIC PF 连接 CPU Root Port,用于传统主机侧访问。
Direct NIC 不是一般意义上“完全不经过 PCIe”,而是优化 PCIe 拓扑,让 GPU 与 NIC 之间不再受较慢 CPU 根路径限制。
#第七部分:MoE 为什么让网络更难
#15. All-to-All 与负载不均
MoE 中,每个 token 根据路由器选择专家。不同专家收到的 token 数量可能不同,因此 All-to-All 同时面临:
- 发送量不均;
- 热门专家所在节点成为热点;
- 不同 rail 或不同 Dragonfly 组之间出现集中流量;
- 最慢专家或最拥塞路径决定整个迭代完成时间。
#16. MoE 通信优化
#16.1 RailS
RailS 利用 Rail 架构的对称性,把全局流量协调转化为各节点的本地调度。每个节点使用最长处理时间优先(LPT)调度,把大流优先分配到当前负载较低的 rail,并并行激活多条 rail。
其核心推导利用“均匀发送可导出均匀接收”的对称性,使节点不需要持续交换完整的全局流量矩阵,也能在本地近似平衡发送与接收负载。
论文报告的合成和真实 MoE 工作负载结果包括:
- 总线带宽提升约 20%–78%;
- 完成时间减少约 17%–78%;
- Mixtral 迭代时间缩短约 18%–40%。
上述结果依赖论文测试平台、流量矩阵和基线配置。
#16.2 其他方案
- LAER-MoE:在训练过程中根据负载动态调整专家位置和 token 路由,减少热点链路。
- EfficientMoE:结合动态专家调度与热专家副本,并在静态图编译前为热点专家安排副本;相应实验中 All-to-All 通信减少最高约 75%。
MoE 优化不能只改网络或只改模型:需要联合考虑专家放置、容量因子、token 路由、rank 映射、物理拓扑和拥塞控制。
#第八部分:扩展性、诊断与技术演进
#17. 强扩展与弱扩展
#17.1 强扩展
强扩展固定总任务量并增加设备数。理想情况下:
但设备增加后,单卡计算量下降,通信启动、同步和尾延迟通常不会同比下降,所以实际加速逐渐偏离线性。
#17.2 弱扩展
弱扩展让总任务量随设备数增加,使每个设备的计算负载近似不变,考察设备增加后单步时间是否仍然稳定。
论文或技术报告声称“线性扩展”时,必须说明是强扩展还是弱扩展,并说明全局 batch size 是否变化。
#18. 如何判定应该优化什么
| 观测 | 优先怀疑 | 对应方向 |
|---|---|---|
| 小张量同步次数多且很慢 | 启动延迟、同步频率 | Tree/低延迟算法、融合小消息、对称内存 |
| 大张量吞吐低 | 链路带宽、拥塞、GPU-NIC 路径 | 分层 AllReduce、拓扑映射、GPUDirect RDMA、SHARP |
| 平均速度正常但 P99 很慢 | straggler、路由不均、热点 | 自适应路由、任务放置、RailS |
| TP 规模增大后反而变慢 | 高频层内通信 | 减小 TP 域、通信重叠、序列并行 |
| MoE 迭代时间波动大 | All-to-All 与专家热点 | 专家重布局、热专家副本、RailS |
| Leaf 内快、跨 Leaf 明显变慢 | 上行超售或 Spine 拥塞 | 检查超售比、ECMP/自适应路由、并行组映射 |
| RoCE 出现 Pause 或吞吐抖动 | PFC、ECN、DCQCN 参数不匹配 | 优先检查队列阈值、速率反馈和流量分类 |
#19. 技术演进主线
单 GPU 计算 → 节点内多 GPU → 跨节点数据并行 → Ring/Tree 集合通信 → 拓扑感知与分层 AllReduce → RDMA/GPUDirect 降低拷贝 → SHARP 将归约下沉到网络 → Rail 优化固定并行流量 → MoE 促使网络转向全局 All-to-All、专家放置和动态负载均衡
这条演进线说明:网络优化不只是“换更快的网卡”。它同时涉及:
- 模型怎样切分;
- 集合通信怎样组织;
- rank 怎样映射到 GPU 和 NIC;
- 交换机怎样连接;
- 路由如何避开拥塞;
- 通信能否与计算重叠。
#原始资料
- NCCL:Collective Operations
- NVIDIA:GPUDirect RDMA
- NVIDIA:Advancing Performance with SHARP
- NVIDIA:Enabling Fast Inference and Resilient Training with NCCL 2.27
- NVIDIA:RoCE 文档
- NVIDIA:DGX SuperPOD Compute Fabric
- NVIDIA:HGX AI Factory Networking Physical Topologies
- NVIDIA:InfiniBand Cluster Bring-up Procedure
- NVIDIA:Dragonfly+ Topology Validation
- RailS: Load Balancing for All-to-All Communication in Distributed MoE Training