所属: 基础设施层。本页边界: 怎样判断一个 kernel 是计算受限还是带宽受限。
#核心公式
#符号说明
| 符号 | 含义 | 单位/条件 |
|---|---|---|
| 实际达到的计算吞吐 | FLOP/s | |
| 硬件峰值计算吞吐 | FLOP/s | |
| 算术强度 | FLOP/Byte | |
| 目标内存层的有效带宽 | Byte/s | |
| 算子执行的浮点运算量 | FLOPs | |
| 从目标内存层搬运的字节数 | Byte | |
| Roofline 拐点(ridge point) | FLOP/Byte | |
| 有效带宽(与 互换使用) | Byte/s |
#技术要点
- 算术强度定义为:
- 矩阵乘通常算术强度高;逐 token decode 常较低。
- 算子融合、分块和重计算主要改变字节移动。
- Roofline 给出上界,不替代真实 profiling。
- 实际 GPU 上存在多级 Roofline:HBM、L2、L1/共享内存各有自己的带宽屋顶,kernel 可能被任意一层限制。
- Prefill 阶段通常计算受限;Decode 阶段通常带宽受限。同一模型在不同阶段的有效瓶颈完全不同。
#原理与演进
#用 Roofline 定位瓶颈
- :运算量;:从目标内存层搬运的字节;:从带宽限制转为算力限制的拐点。
- 满足下式时,提高峰值 FLOP/s 基本不能改变上界;应减少 或提高有效带宽。
- 满足下式时,关注矩阵单元利用率、并行粒度和算子形状。
- 算子融合减少中间结果写回,tiling 增加片上复用;二者改变 ,不是凭空增加硬件算力。
#为什么实际 GPU 上需要“多级 Roofline”
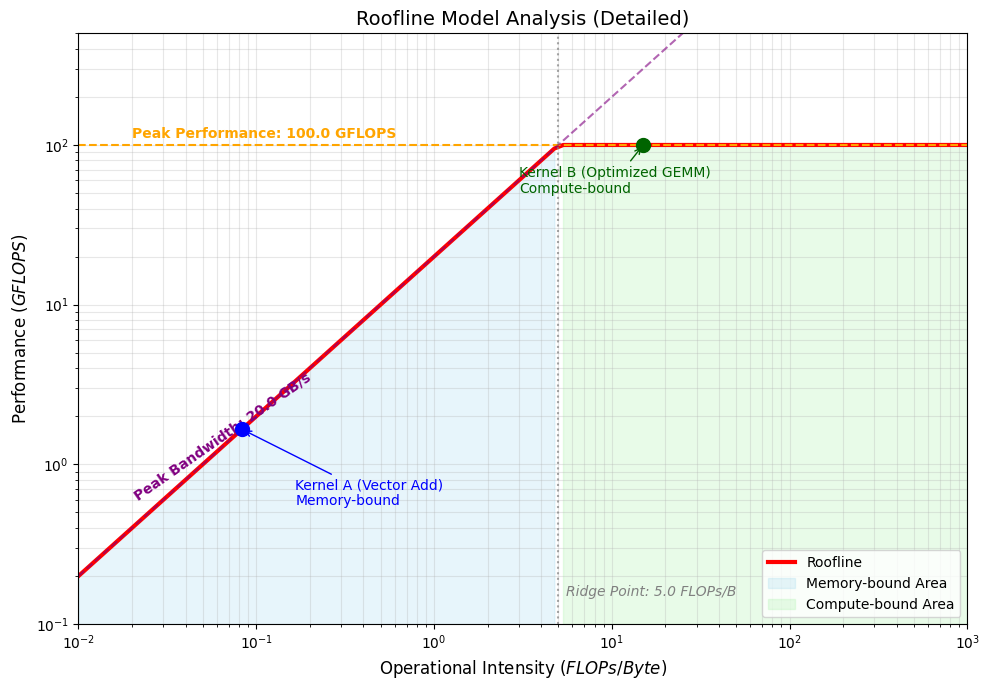
基础 Roofline 模型只画了一条带宽屋顶线,但真实 GPU 存在多个存储层次,每个层次都有自己的带宽上限。如果只使用 HBM 带宽来绘制 Roofline,kernel 可能看起来远低于屋顶,但实际上已经被 L2 或共享内存带宽限制。
NVIDIA Nsight Compute 现已内置 Roofline 分析,并支持分层 Roofline(Hierarchical Roofline) ,将 L1 和 L2 缓存层级分别绘制为不同的屋顶线。当一个 kernel 的算术强度落在 HBM 屋顶线以下但高于 L2 屋顶线时,说明该 kernel 受 HBM 带宽限制;如果落在 L2 屋顶线以下,则说明 L2 带宽或缓存命中率才是瓶颈。
这一扩展的实际价值在于:如果一个 kernel 的数据能大部分命中 L2 缓存,其有效带宽可远高于 HBM 标称带宽,Roofline 上界随之提高。反之,如果 L2 命中率低,即使 HBM 带宽充裕,实际吞吐也可能受缓存缺失影响。
#注意力算子的演进
- 朴素实现显式生成 注意力分数,中间读写压力大。
- 分块精确注意力在片上计算局部块,并用在线 softmax 合并结果,降低 HBM 传输。FlashAttention 原论文
- 更长上下文仍会增加计算或 KV 体积;需结合长上下文与推理分析。
边界: Roofline 是理想上界;启动开销、占用率、同步和不规则访存会使实测性能更低。
#1. 从时间下界推导 Roofline
设一次算子做 次浮点运算,需从目标内存层搬运 字节;硬件峰值算力为 ,可持续有效带宽为 :
两边用 相除可得到:
- 横轴 :每搬运一字节完成多少运算;纵轴 :实际每秒运算数。
- 拐点定义为:左侧是带宽屋顶,右侧是计算屋顶。
- 必须说明 针对 HBM、片上缓存还是网络测量;换一层存储, 和 都可能变化。
- 该式是上界而非运行时间精确预测;启动延迟、依赖和串行比例没有包含在内。Roofline 原始论文目录
#1.1 Roofline 在 LLM 场景中的具体应用
Prefill 与 Decode 的算术强度差异。 Prefill 阶段所有输入 token 并行处理,线性层的权重加载成本被大量 token 分摊,算术强度较高,通常落在 Roofline 的计算屋顶一侧。Decode 阶段每步仅处理一个(或极少量)token,权重复用率极低,算术强度远低于拐点,落在带宽屋顶一侧。这意味着:Prefill 的优化方向是提高矩阵单元利用率(分块、低精度),Decode 的优化方向是降低每步的数据搬运量(量化和 KV 管理)。
H100 上的具体数值。 以 H100 为例:FP16 Tensor Core 峰值约 989 TFLOPS,HBM3 带宽约 3.35 TB/s,拐点约为下式所示数值,单位为 FLOP/Byte。Prefill 阶段的大批量 GEMM 算术强度可达数千,远高于拐点,属于计算受限。Decode 阶段的矩阵-向量乘算术强度约为 1 FLOP/Byte 量级,远低于拐点,属于带宽受限。
分布式训练的通信 Roof。 随着分布式训练规模扩大,GPU 间通信逐渐成为性能核心瓶颈。NVLink、PCIe、InfiniBand 乃至 AllReduce 的吞吐能力都可以被抽象为新的通信屋顶。Roofline 的“带宽天花板”概念从 HBM 扩展到 NVLink 和 RDMA 层级,形成“带宽瀑布”:HBM → NVLink → RDMA,每一级的带宽数量级不同,优化时需要明确当前瓶颈在哪一级。
#2. 用三类算子判断优化方向
| 算子 | 数据访问形态 | 常见限制 | 合适的改进 |
|---|---|---|---|
| 大矩阵乘 | 权重与输入可反复复用 | 矩阵单元利用率、形状 | 分块、合适批量、低精度 |
| 逐元素激活/归一化 | 每元素计算少,需读写张量 | HBM 带宽 | 与相邻算子融合 |
| 小批量 Decode | 逐步依赖且权重复用少 | 权重/KV 带宽及启动 | 合并请求、KV 管理、减少搬运 |
#3. Tiling、融合、重计算与低精度分别改变什么
设算子需要执行的浮点运算量为 ,访问片外显存的数据量为 ,则算术强度为:
根据 Roofline 模型,算子的性能上限近似为:
优化算子的基本思路只有三类:减少显存访问量 ;提高有效计算吞吐 ;改变计算量 与存储量之间的权衡。
#3.1 Tiling:利用片上存储提高数据复用
Tiling(分块计算) 是把大矩阵或大张量切分成若干小块,将当前需要的数据块加载到寄存器或片上 SRAM 中,使其在被替换前参与多次计算。
以式(1)所示的矩阵乘法为例,如果直接从显存反复读取 和 的元素,同一个元素可能被读取多次。Tiling 将计算划分为式(2),每次把 的一个 tile 加载到片上存储,随后在片上完成多个乘加操作。
式(1):
式(2):
假设方形 tile 的边长为 ,每个元素占 字节。一次 tile 矩阵乘法大约需要式(1)所示次数的运算,只考虑读取两个输入 tile,显存访问量约为式(2)。算术强度近似为:
式(1):
式(2):
在片上容量允许的范围内,增大 tile 可以让每次显存读取服务于更多计算。
Tiling 改变:,。这里的 指相对于无复用实现,单位计算对应的片外显存访问量下降;矩阵乘法的数学 FLOPs 基本不变。
解决的问题:减少相同数据被重复读入显存的次数;提高寄存器和共享内存中的数据复用率;将算子从 memory-bound 推向 compute-bound;更充分地利用 Tensor Core 等矩阵计算单元。
新问题:tile 太小复用不足;tile 太大寄存器或共享内存占用过高;单个线程块资源占用过大时同时驻留的线程块数量下降;边界尺寸不能被 tile 整除时需要额外处理;不合适的访存布局可能产生非合并访问或共享内存 bank conflict。
Double Buffering。 Tiling 的标准搭档是双缓冲:在计算当前 tile 的同时,异步预取下一个 tile 到另一块缓冲区。这样数据加载延迟可以被当前 tile 的计算隐藏。但双缓冲本身不增加算术强度,它优化的是延迟隐藏而非带宽利用。实测表明,在某些 kernel 中双缓冲的收益主要来自向量化加载(如 float4)而非流水线本身。
#3.2 Kernel 融合:消除中间张量的片外读写
Kernel 融合是把多个原本独立启动的算子合并到同一个 Kernel 中,使中间结果保留在寄存器或片上 SRAM,而不是写回 HBM 后再重新读取。
假设有两个逐元素算子,分别如式(1)、式(2)所示。不融合时,需要依次执行两个 Kernel,显存访问量约为式(3)(FP16 下读 、写 、读 、写 ,各 字节)。融合后直接计算式(4),中间张量 不再写回显存,流量如式(5)所示。若总计算量满足式(6),则算术强度从 提高到 FLOP/Byte,翻倍。
式(1):
式(2):
式(3):
式(4):
式(5):
式(6):
除了减少中间张量读写,融合还会减少 Kernel 启动次数。若每次 Kernel 启动开销为 ,将 个 Kernel 融合为一个,理论上可减少约 的启动开销。
Kernel 融合改变:,,。
解决的问题:减少中间张量写入和读取 HBM;减少 Kernel 启动及同步开销;提高逐元素算子、归一化和激活函数的执行效率;降低短小 Kernel 之间的调度开销。
典型融合:Linear → Bias → Activation 可以融合为 FusedLinearBiasActivation;Residual → Dropout → LayerNorm 融合为一个 Kernel。
新问题:
- 融合后单个 Kernel 的寄存器需求可能明显增加。当寄存器需求超过硬件或编译器分配上限时,发生 Register spilling(寄存器溢出) ,中间数据被重新写入本地内存或显存。PTXAS 编译器会为整个 kernel 做联合寄存器分配,一个“寄存器贪婪”的子 kernel 可能抬升整个二进制的寄存器占用,导致所有子 kernel 的 occupancy 下降。
- Kernel 过大可能降低 occupancy。在 Blackwell 等架构上,强制将两个高寄存器需求的线程块放入同一 SM 可能导致寄存器溢出,反而降低性能。
- 算子之间如果存在复杂分支、动态形状或全局同步,不适合融合。
- 过度融合增加编译时间和调优难度;中间结果不再物化后,调试和性能分析更困难。
因此,融合的目标不是“把所有算子放进同一个 Kernel”,而是消除收益明显、依赖关系简单的中间显存访问。
#3.3 重计算:用额外 FLOPs 换取显存容量和搬运量
重计算(Recomputation / Activation Checkpointing) 是指前向传播时不保存某些中间激活,反向传播需要这些激活时再根据输入重新计算。
设原始计算量为 ,重计算引入额外计算量 ,则有式(1)。如果原本需要保存的激活占用 ,重计算后只保留部分检查点,如式(2)所示。
式(1):
式(2):
重计算改变:,,部分实现中 。
只有当下面的收益足够大时,重计算才值得采用:
更常见的情况是:即使重计算不能直接缩短单步时间,它也能降低激活显存,从而允许更大的 batch size、更长的上下文或更大的模型。
解决的问题:减少训练时激活显存;允许增加序列长度或 batch size;让原本无法放入显存的模型能够训练;避免将大量激活卸载到 CPU 或磁盘。
新问题:反向传播需要重复执行部分前向计算,训练 FLOPs 和单步时间增加;检查点切分过细时调度与 Kernel 启动开销增加;切分过粗时显存节省有限;随机操作需要保证前后重计算的一致性;对计算密集型算子,重计算代价可能明显高于节省的显存搬运。
#3.4 低精度:减少单元素字节数并提高计算吞吐
低精度计算将 FP32 数据转换为 BF16、FP16、FP8、INT8 或更低位宽格式。
若张量包含 个元素,每元素占 字节,则 FP32、FP16、INT8 的存储量分别为 。在 FLOPs 不变的近似下,从 FP32 变为 FP16 后,算术强度约提高为原来的 2 倍。低精度还可能启用专门的矩阵计算单元,使下式成立。
低精度改变:,,。
解决的问题:减少权重、激活、梯度和 KV Cache 的容量;降低显存带宽压力;提高 Tensor Core 等矩阵单元的吞吐;提高可支持的 batch size 和并发数。
新问题:表示范围不足可能产生上溢或下溢;尾数位减少增加舍入误差;激活和权重中的离群值降低量化精度;量化与反量化产生额外计算;如果硬件没有对应低精度 Kernel,文件变小不一定意味着推理更快;某些归约、归一化或优化器状态仍需使用较高精度。
#3.5 四种技术改变的对象不同
| 技术 | 主要改变 | 核心收益 | 主要代价 |
|---|---|---|---|
| Tiling | 降低单位计算对应的片外访问量 | 提高数据复用与算术强度 | 片上资源占用增加 |
| Kernel 融合 | 降低中间张量访问量和启动次数 | 减少 HBM 流量与调度开销 | 寄存器压力和 Kernel 复杂度增加 |
| 重计算 | 增加 ,降低激活容量 | 用计算换显存 | 训练 FLOPs 和时间增加 |
| 低精度 | 降低每元素字节数,可能提高峰值吞吐 | 降低容量和带宽压力 | 数值误差及转换开销 |
#3.6 这些优化为什么会互相冲突
这些技术并不能无限叠加,因为它们会竞争寄存器、共享内存、计算单元和调度资源。
更大的 tile 可能降低并发度。 tile 增大通常提高数据复用,但会增加每个线程块的共享内存和寄存器占用,导致同时驻留的线程块数量下降。当 occupancy 下降时,GPU 隐藏访存延迟的能力可能减弱。
过度融合可能造成寄存器溢出。 融合更多算子需要同时保留更多中间值。如果寄存器需求超过硬件上限,中间数据可能发生 register spilling,此时融合原本想消除的显存访问可能重新出现。在 PyTorch Inductor 中,编译器会在融合时检查寄存器溢出和 occupancy 影响,只有收益明显时才选择融合。
重计算会与计算密集型算子争抢算力。 如果算子原本已经是 compute-bound(下式),增加重计算会直接增加关键路径上的 FLOPs,而显存流量下降无法带来足够收益。
低精度可能引入转换与反量化开销。 如果低精度数据在计算前必须转换为高精度,当张量较小或 Kernel 不匹配时,转换开销可能抵消带宽收益。
#3.7 判断优化是否有效
不能只比较理论 FLOPs,而应同时检查:HBM 实际读写字节数是否下降;算术强度是否提高;Kernel 启动次数是否减少;寄存器和共享内存占用是否过高;occupancy 是否下降;是否出现 register spilling;实际吞吐和端到端延迟是否改善;低精度是否造成不可接受的数值误差。
最终目标不是让某个局部指标最大,而是降低端到端时间:
技术路线可以概括为:无数据复用 → Tiling 提高片上复用 → Kernel 融合消除中间显存访问 → 重计算用 FLOPs 换显存 → 低精度减少每元素字节数并提高专用计算吞吐 → 联合调优寄存器、共享内存、并发度与数值精度。
#4. FlashAttention 的准确数学含义
普通注意力常显式写出式(1)和式(2)。当序列长度为 ,中间分数矩阵有 元素。
式(1):
式(2):
对某一查询行分块处理 logits ,维护当前最大值 、归一化和 、未归一化输出 :
- 这组在线更新保持与完整 softmax 相同的数学结果(有限精度下允许数值舍入差异)。
- 只在片上处理当前块,避免把完整分数矩阵反复写到 HBM;因此是 I/O 改善,不是把全注意力改成近似稀疏注意力。FlashAttention 原论文
- 长序列的成对乘积计算仍存在;长度能力与算法复杂度分别由长上下文解释。
#4.1 FlashAttention 的 I/O 复杂度分析
标准注意力的 HBM 访问量。 标准注意力分三步执行:第一步计算式(1),读 ,写 ;第二步对 做 softmax,读 ,写 ;第三步计算 ,读 ,写 。总 HBM 访问量约为 字节(FP16 下乘 2),主导项为 。当满足式(2)时,仅一个中间矩阵的 HBM 流量就约 32 GB。
式(1):
式(2):
FlashAttention 的 HBM 访问量。 FlashAttention 将 分块,只将当前块加载到 SRAM, 的分数矩阵从不写入 HBM。外循环遍历 块,内循环遍历 块。 和 块被读取下式所示次数,总访问量为 ,主导项为 。当 取最优值 时( 为 SRAM 大小),复杂度为 。
数量级对比。 在典型配置下(式(1)、式(2)、FP16),标准注意力将约 97% 的 HBM 流量浪费在中间 矩阵上,FlashAttention 将 HBM 流量降低约 33 倍。由于 HBM 读写速度远慢于 SRAM,即使 FlashAttention 执行了更多 FLOPs(用于在线 softmax 的重缩放),总运行时间仍然显著减少。
式(1):
式(2):
边界条件。 FlashAttention 的收益在 prefill 阶段最大,因为 prefill 处理大量 token 的并行注意力,中间矩阵的 HBM 流量是主导瓶颈。单 token decode 阶段的注意力计算只涉及一个查询向量与已有 KV 的交互,中间矩阵本来就很小,FlashAttention 带来的差异有限。GQA/MQA 通过减少 KV 头数来降低 KV Cache 大小,与 FlashAttention 的 I/O 优化是正交的。
#5. 性能低于屋顶时怎样解释
| 观察 | 可能机制 |
|---|---|
| HBM 带宽已接近有效上限 | 算子受搬运限制 |
| 带宽和算力都低 | 小算子、同步、占用不足、数据依赖 |
| 大 batch 快、小 batch 慢 | 权重复用与并行度不同 |
| 多卡比单卡慢 | 通信/同步超过并行收益 |
| 分层 Roofline 中位于 L2 屋顶线以下 | L2 带宽或缓存命中率是瓶颈 |
测量口径: 同时记录端到端延迟、每阶段耗时、有效带宽、实际矩阵形状和设备忙时。NVIDIA Nsight Compute 的 SpeedOfLight_RooflineChart 功能可直接在 profiling 时收集 Roofline 数据,并支持通过自定义 Hierarchical Roofline 配置文件扩展到 L1 和 L2 层级。Roofline 只能定位方向,不能代替实验结果。